
Модель Qwen 3.8 от Alibaba не догнала Claude Fable 5.1 и GPT-6 Astra по чистому интеллекту, зато обходит их по цене в 5–66 раз. Qwen 3.8 Omni Flash за $0.15 за миллион токенов разбирает часовое видео и аудио, а Qwen 3.8 Max на агентных бенчмарках встает рядом с Claude Opus 4.8. Ниже разберем всю линейку Qwen 3.8, сравним ее с флагманами Anthropic и OpenAI и посчитаем, сколько стоит одна реальная задача у каждой модели.
TL;DR. Линейка Qwen 3.8 в октябре 2026 состоит из трех моделей: Max (2,4 трлн параметров, $2/$6), открытая 27B (Apache 2.0) и Qwen 3.8 Omni Flash для видео и аудио ($0.15/$0.47). Claude Fable 5.1 и GPT-6 Astra сильнее в сложном коде, но стоят $10/$50. В статье: таблицы цен, тесты из YouTube и карта выбора под задачу.
Что входит в линейку Qwen 3.8 в 2026 году?
Три модели под разные задачи. Max для кода и агентов, 27B для локального запуска, Qwen 3.8 Omni Flash для мультимедиа. Путать их нельзя, у каждой свои цены и лицензия.
Alibaba выпускала Qwen 3.8 частями летом и осенью 2026 года. Превью Max показали 19 июля на WAIC в Шанхае, 27B вышла с открытыми весами 17 августа, а Qwen 3.8 Omni Flash появилась 18 сентября. Max и Omni Flash держат контекст до 1 млн токенов, но решают совсем разные задачи.
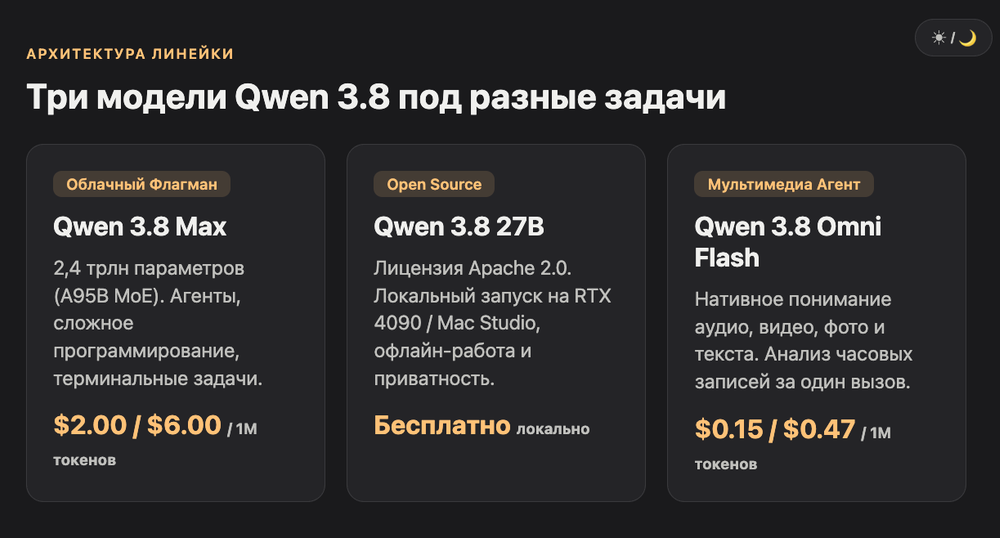
Главная путаница начинается с названия. «Qwen 3.8» в выдаче означает то гигантский хостинговый флагман, то маленькую модель для ноутбука. Бенчмарки одной часто приписывают другой.
| Модель | Параметры | Контекст | Цена (input/output за 1M) | Веса |
|---|---|---|---|---|
| Qwen 3.8 Max | 2,4 трлн, MoE (A95B) | 1M / 131K вывод | $2 / $6 (от $1.65 / $4.95) | Кастомная лицензия |
| Qwen 3.8 27B | 27 млрд | не раскрыт | бесплатно локально | Apache 2.0 |
| Qwen 3.8 Omni Flash | не раскрыто | 1M / 131K вывод | $0.15 / $0.47 | Закрыты |
Цены по состоянию на октябрь 2026, данные CloudPrice и OpenRouter.
Чем Qwen 3.8 Omni Flash отличается от обычных моделей?
Qwen 3.8 Omni Flash слушает и смотрит одновременно. Она принимает текст, картинки, аудио и видео в одном запросе, но отвечает только текстом.
Qwen 3.8 Omni Flash вышла 18 сентября 2026 года и стала первой агентной моделью Qwen с нативным пониманием аудио и видео. За один вызов она обрабатывает до часа непрерывной записи. По данным Alibaba, она в среднем на 26% сильнее Qwen3.5-Omni-Plus на ~30 тестах.
Omni (от латинского «все») значит, что модель не склеивает несколько нейросетей. Звук, картинка и текст попадают в одну архитектуру сразу. Поэтому она ловит связи, которые теряются при отдельной транскрибации: интонацию спикера, слайд на экране в момент фразы, звук за кадром.
Что умеет Qwen Omni Flash на практике
Карточка модели на OpenRouter перечисляет конкретные сценарии. Вот что из них полезно вайбкодеру:
- разбор YouTube-туториала с выжимкой кода и шагов прямо со слайдов
- анализ записи созвона: кто что обещал, где спорили, какие задачи появились
- пространственное аудио на 2 и 4 канала, редкость даже среди флагманов
- работа с интерфейсом компьютера (GUI) по видео экрана
- распознавание речи на 74 языках, включая русский
Есть нюанс. Модель не говорит голосом. Для голосового бота придется подключать отдельный TTS (синтез речи).
Сколько стоит Qwen 3.8 Omni Flash и где ее запустить?
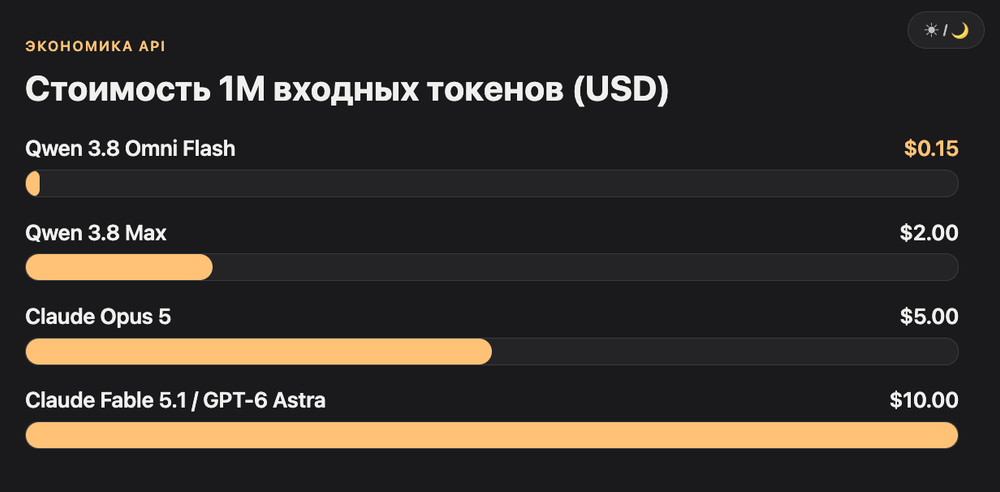
$0.15 за миллион входных токенов и $0.47 за выходные. Это одна из самых дешевых мультимодальных моделей 2026 года, доступная только через API.
Qwen 3.8 Omni Flash стоит $0.15 за 1M входных токенов, $0.47 за выходные и $0.016 за кэшированный ввод. По заявлению Alibaba, час обработки аудио обходится на 98% дешевле, чем у Qwen3.5-Omni-Plus. Открытых весов нет, запуск только через Alibaba Cloud Model Studio, Qwen Studio и OpenRouter.
Для сравнения: GPT-6 Astra берет $10 за тот же миллион входа. Разница в 66 раз. Для задач вроде «прогони 200 видео и вытащи из них лайфхаки» это меняет экономику проекта целиком.
Мы в VibeCoderz похожим конвейером собирали конспекты YouTube-видео для каталога. Лиза рассказывала, как это выглядело до автоматизации:
Лиза: «Раньше для одной статьи я вручную смотрела 15–20 видео. Написала скрипт в Google Таблицах: вставляешь ссылки, он транскрибирует и разбирает каждое по 15 критериям. Было 4 часа, стало 5,5 минут. Прикинь, сколько времени теперь освобождается на сам текст.»
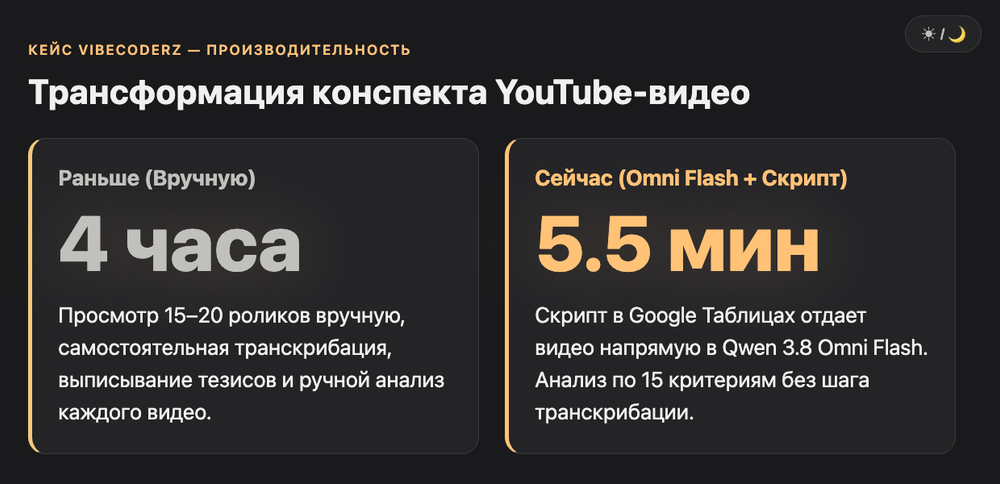
Omni Flash позволяет пропустить шаг транскрибации и отдавать модели видео целиком. Если вы ведете канал, присмотритесь к ИИ-агенту для ютубера, он закрывает похожие задачи без кода.
Насколько силен Qwen 3.8 Max в программировании?
На агентных и терминальных тестах Qwen 3.8 Max почти догоняет Claude Opus 4.8. В сложной архитектуре и долгих агентных сессиях он пока уступает Opus 5 и Fable 5.1.
По данным APIYI, Qwen 3.8 Max набирает 67.7% на SWE-bench Pro и 86.6% на Terminal-Bench 2.1, а на PaperBench доходит до 93.0. Это вендорские цифры: независимые лаборатории ставят модель ниже Fable 5.1, но рядом с Opus 4.8. Цена при этом в 2,5 раза ниже Opus.
Qwen 3.8 Max построена на архитектуре MoE (Mixture of Experts). Из 2,4 трлн параметров на каждый токен включается только часть, около 95 млрд, это видно из полного названия Qwen3.8-2.4T-A95B. Поэтому огромная модель работает быстрее и дешевле, чем подсказывает ее размер.
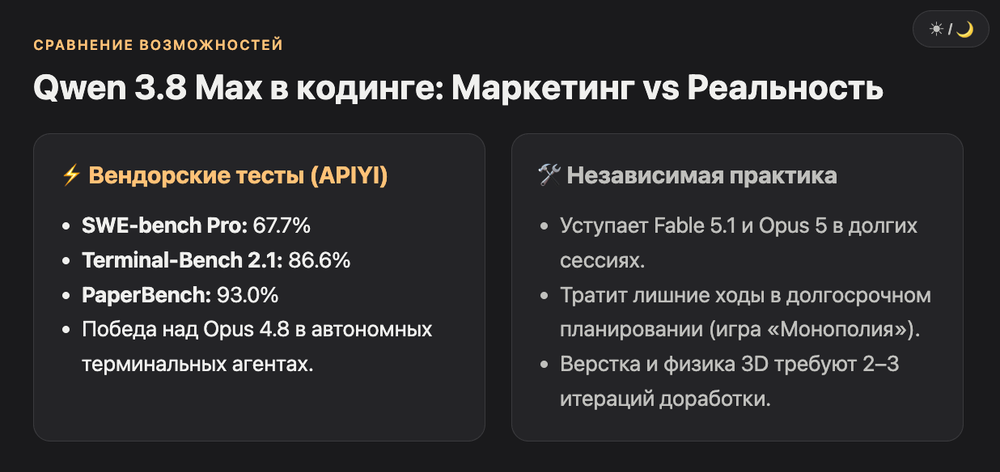
Цифры из материала APIYI о запуске пока никто не перепроверил. Отнеситесь к ним как к заявке Alibaba, а не к факту.
Что показали тесты на YouTube
В таблице транскрибаций, которую мы разобрали для статьи, 12 роликов с живыми тестами. Картина у авторов совпадает:
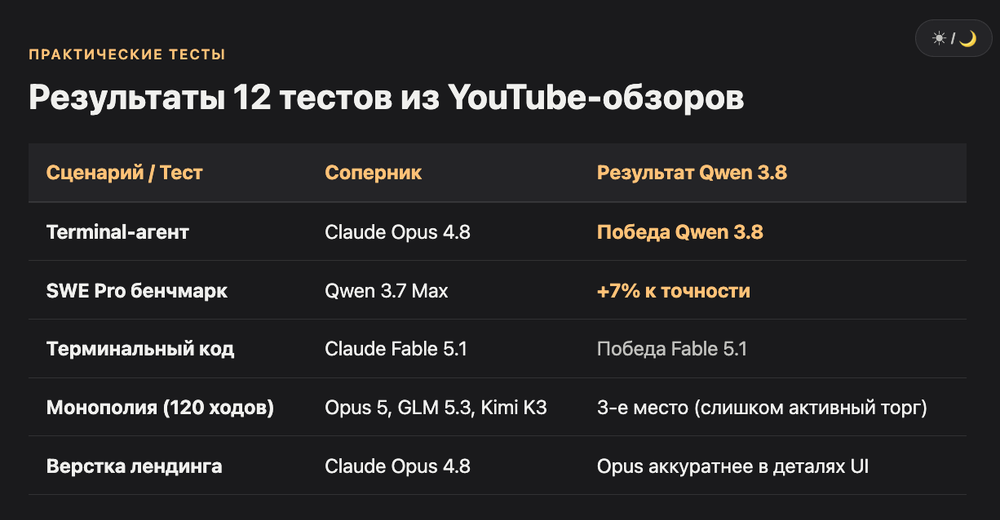
| Тест | Результат Qwen 3.8 |
|---|---|
| SWE Pro против Qwen 3.7 Max | +7%, по словам автора обзора |
| Terminal-агент против Opus 4.8 | Qwen выигрывает |
| Terminal-агент против Fable 5 | Fable выигрывает |
| Монополия на 120 ходов | 3 место после Opus 5 и GLM 5.3, Kimi K3 последний |
| Лендинг против Opus 4.8 | Opus аккуратнее в верстке |
| Финансовый трекер, кубик Рубика, криптобиржа | работают, но визуал и физика требуют 2–3 доработок |
В Монополии Qwen 3.8 слишком активно торговал и остался ни с чем. Смешной тест, но он хорошо показывает проблему долгосрочного планирования.
Чем Claude Fable 5.1 и Opus 5 лучше модели Qwen 3.8?
Claude выигрывает там, где задача длинная и ошибка дорогая: рефакторинг большой кодовой базы, многошаговые агенты, архитектура. За это вы платите в 2,5–8 раз больше.
Claude Fable 5.1 вышла 1 сентября 2026 года и стоит $10/$50 за миллион токенов, Claude Opus 5 вышла 24 июля и стоит $5/$25. Обе держат 1M контекста и 128K вывода. Для Opus 5 опубликован результат 96% на SWE-bench Verified, это один из лучших показателей среди публичных моделей.
Fable 5.1 сейчас лидер по индексу Artificial Analysis: 66 баллов против 61 у GPT-6 Astra. По данным сравнения на AnotherWrapper, она выигрывает у Opus 5 в 30 из 40 общих тестов. Но Opus 5 вдвое дешевле и для 90% повседневного кода разницы вы не заметите.
Сильные стороны Claude
Opus 5 и Fable 5.1 держат контекст на всей длине сессии. Если агент открыл 40 файлов и правит пятнадцатый, он помнит, зачем трогал первый. Qwen 3.8 Max в таких сценариях чаще теряет нить и начинает переделывать уже готовое.
Вторая сильная сторона: экосистема. Claude Code и Cursor заточены под Claude, субагенты и MCP работают из коробки. С Qwen многое придется настраивать руками.
Слабые стороны Claude
Цена. Одна долгая агентная сессия на Fable 5.1 легко съедает $10–20. Автор одного из тестов отметил, что на простых задачах вроде трекера дней рождения Opus 5 тратит в разы больше Qwen и не дает заметной прибавки в качестве. Плюс у Claude нет открытых весов, самостоятельно развернуть модель нельзя.
GPT-6 Astra или Qwen 3.8, что выбрать для агентных задач?
GPT-6 Astra сильнее в автономной работе с компьютером и математике. Qwen 3.8 Max берет ценой и близкими результатами на терминальных задачах.
GPT-6 Astra вышла 3 сентября 2026 года по цене $10/$50 за 1M токенов, как у Fable 5.1. Модель набирает 72.6% на OSWorld 2.0 и 98.6% на ARC-AGI-3. По оценке Artificial Analysis, задача на Astra обходится в $4.72 против $9.18 у Fable 5.1 за счет меньшего числа шагов.
У Astra есть важный подвох в прайсе. Если промпт длиннее 272K токенов, весь запрос тарифицируется по $20/$75, разбор есть в гайде eesel.ai. Для агента, который читает большой репозиторий, такой порог пробивается быстро.
Что показали тесты в Blender и Godot
Три ролика из нашей таблицы сравнивают GPT-6 Astra и Qwen 3.8 27B через MCP в Blender. Astra с третьей попытки собрала Honda Accord с протектором, логотипом и противотуманками, но уперлась сначала в пятичасовой, а потом в недельный лимит подписки.
Локальная Qwen 3.8 27B делала один автомобиль около двух часов. Результат вышел больше похожим на машину 1957 года, чем на Accord. Велосипед модель оценила на 7 из 10 и честно назвала седло «скругленным бруском».
Вывод авторов совпадает с нашим опытом. Astra дает основу, которую можно доводить руками. Локальная 27B годится для экспериментов, но не для продакшена.
Сколько стоит одна задача на каждой модели?
На типичной агентной задаче Qwen 3.8 Omni Flash обходится в 4 цента, Qwen 3.8 Max в полдоллара, а Fable 5.1 и GPT-6 Astra около $3.
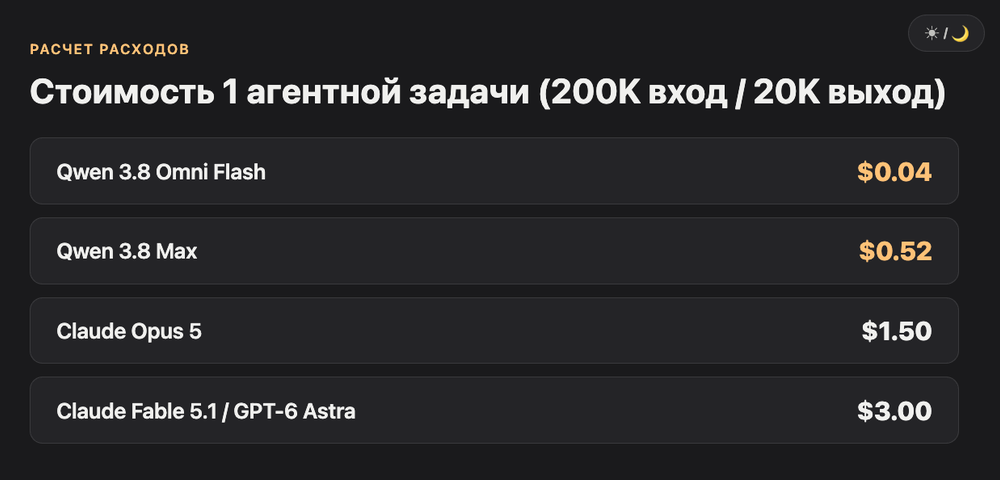
Посчитаем задачу из 200 тысяч входных и 20 тысяч выходных токенов, без кэша. Qwen 3.8 Omni Flash стоит $0.04, Qwen 3.8 Max $0.52, Claude Opus 5 $1.50, а Claude Fable 5.1 и GPT-6 Astra по $3.00. Разница между крайними точками 75 раз.
| Модель | Input / Output за 1M | Задача 200K + 20K | Сильная сторона |
|---|---|---|---|
| Qwen 3.8 Omni Flash | $0.15 / $0.47 | $0.04 | Видео, аудио, длинные записи |
| Qwen 3.8 Max | $2 / $6 | $0.52 | Терминал, фронтенд, цена |
| Qwen 3.8 27B | локально | $0 + электричество | Приватность, офлайн |
| Claude Opus 5 | $5 / $25 | $1.50 | Повседневный сложный код |
| Claude Fable 5.1 | $10 / $50 | $3.00 | Максимальное качество |
| GPT-6 Astra | $10 / $50 | $3.00 | Работа с компьютером, математика |
Цены по состоянию на октябрь 2026, стандартный тариф API.
Кэш меняет картину. У Qwen 3.8 Max неявное кэширование снижает цену повторного ввода до $0.25 за миллион, по словам автора одного из обзоров это экономит до 87%. В ролике про DeepSeek v4.1 Flash кэш составил 98% токенов, и 3D-модель велосипеда за 12 млн токенов обошлась в 31 цент.
Можно ли запустить модель Qwen 3.8 локально?
Да, но только версию 27B. Она вышла под Apache 2.0 и работает на одной видеокарте уровня RTX 4090 или на Mac Studio.
Qwen 3.8 27B опубликована 17 августа 2026 года на Hugging Face и ModelScope под лицензией Apache 2.0. Ее можно использовать в коммерческих проектах, дообучать и распространять. Веса Max тоже доступны, но под кастомной лицензией с ограничением для компаний с выручкой от $50 млн в год.
Детали лицензий собрал eWeek. Для соло-вайбкодера и небольшой студии ограничение Max не актуально, но 2,4 трлн параметров дома все равно не поднять.
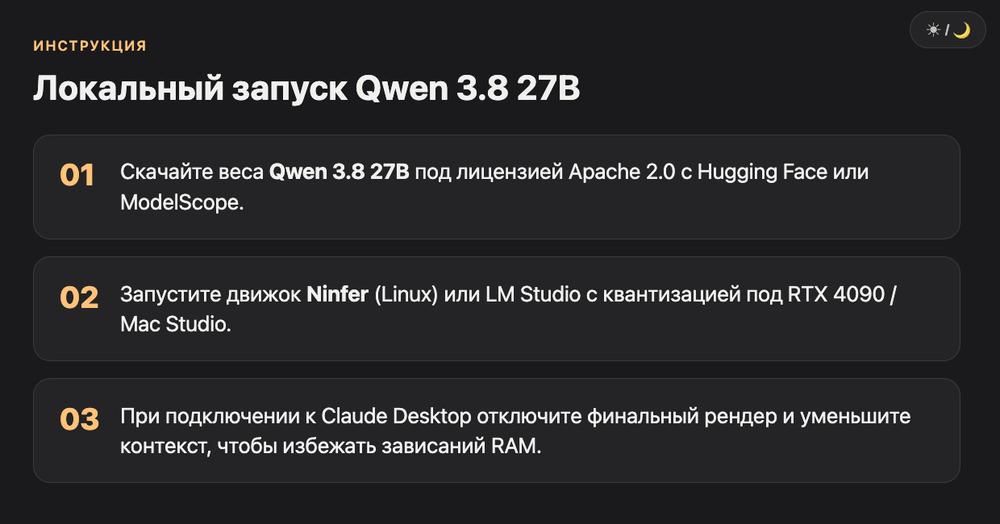
С 27B есть практические грабли. Один из авторов подключил ее к Claude Desktop и обнаружил, что приложение не сжимает контекст для сторонних моделей. Сессия просто упирается в лимит памяти. Помогло уменьшить контекст и отключить финальный рендер, после этого Blender перестал зависать.
Для локального запуска авторы тестов используют движок Ninfer под Linux и агента Hermes. Скорость высокая, но настройка займет вечер.
Как бесплатно попробовать Qwen 3.8 перед оплатой?
Через Qwen Studio бесплатно в браузере или через Alibaba Cloud, где новым аккаунтам дают 1 млн токенов на тесты.
Протестировать Qwen 3.8 Max можно без оплаты двумя способами. Qwen Studio дает доступ к модели прямо в чате, а Alibaba Cloud при регистрации в регионе Сингапур начисляет 1 млн бесплатных токенов для API. На этом лимите авторы тестов собрали финансовый трекер, кубик Рубика и симулятор криптобиржи.
Порядок действий такой:
- Зарегистрируйтесь на alibabacloud.com и выберите регион Singapore.
- Создайте API-ключ в Model Studio.
- Подключите ключ в OpenCode, Cline или любой IDE с поддержкой OpenAI-совместимого API.
- Дайте модели свою реальную задачу, а не задачу из бенчмарка.
Последний пункт главный. Авторы почти всех роликов в нашей выборке приходят к одному: бенчмарк показывает потолок, а ваш проект показывает реальность.
Есть лайфхак из теста DeepSeek против Astra. Не скармливайте слабой модели промпт, который написала сильная. Перегруженный промпт от GPT-6 Astra сбил DeepSeek с толку, и автомобиль превратился в «танк». Пишите задачу своими словами.
Кому какая модель подходит?
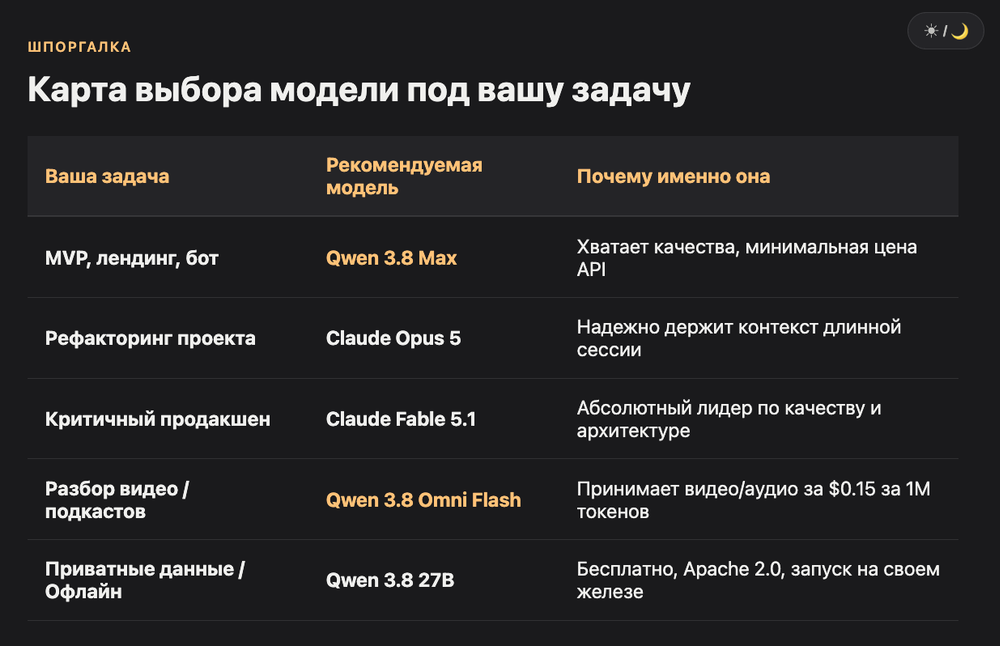
Если бюджет ограничен, берите Qwen 3.8 Max. Если ошибка стоит дорого, Claude Opus 5 или Fable 5.1. Видео и аудио отдавайте Qwen 3.8 Omni Flash.
Выбор модели в 2026 году упирается в цену ошибки. Для прототипов и массовых агентных вызовов Qwen 3.8 Max дает 80% качества флагманов за 15–20% цены. Для продакшен-кода и долгих сессий лучше переплатить за Claude. Мультимедиа выгоднее всего обрабатывать через Qwen 3.8 Omni Flash.
| Ваша задача | Модель | Почему |
|---|---|---|
| MVP, лендинг, телеграм-бот | Qwen 3.8 Max | Хватает качества, дешево |
| Рефакторинг большого проекта | Claude Opus 5 | Держит контекст сессии |
| Сложная архитектура, критичный код | Claude Fable 5.1 | Лидер по индексу AA |
| Агент, который кликает по интерфейсу | GPT-6 Astra | 72.6% на OSWorld 2.0 |
| Разбор видео, созвонов, подкастов | Qwen 3.8 Omni Flash | $0.15 за 1M, час записи за вызов |
| Приватные данные, офлайн | Qwen 3.8 27B | Apache 2.0, своя видеокарта |
Мы в VibeCoderz пишем основной код в Claude Code на Opus. Qwen подключаем для массовых задач, где агент делает сотни вызовов и важна цена каждого. Комбинация моделей обычно выгоднее ставки на одну.
Все упомянутые инструменты с обзорами и тарифами лежат в каталоге AI-инструментов VibeCoderz.
Частые вопросы
Qwen 3.8 Omni и Qwen 3.8 Omni Flash это одно и то же?
На октябрь 2026 Alibaba выпустила только Flash-версию Omni в линейке 3.8. Когда пишут «Qwen 3.8 Omni», почти всегда имеют в виду именно ее. Предыдущее поколение, Qwen3.5-Omni-Plus, Flash превосходит в среднем на 26% по заявлению Alibaba.
Может ли Qwen Omni Flash отвечать голосом?
Нет. Модель принимает аудио и видео, но отвечает только текстом. Для голосового ассистента нужен отдельный сервис синтеза речи. Зато распознает речь на 74 языках и понимает пространственный звук, это редкость для моделей такой цены.
Qwen 3.8 Max лучше Claude Opus 5 в коде?
На терминальных задачах местами да, на сложном рефакторинге нет. Независимые тесты ставят Qwen 3.8 Max рядом с Opus 4.8, а Opus 5 на ступень выше. Если код идет в продакшен, мы бы выбрали Opus 5.
Зачем платить за GPT-6 Astra, если есть Qwen?
Astra сильна в автономной работе с компьютером: 72.6% на OSWorld 2.0. Если агент должен сам кликать по интерфейсам и проходить многошаговые сценарии, она надежнее. Для обычного кода переплата в 5 раз себя не окупает.
Работает ли модель Qwen 3.8 из России?
Через OpenRouter и международный аккаунт Alibaba Cloud работает, но для оплаты нужна зарубежная карта. Локальной 27B карта не нужна вообще: скачали веса с Hugging Face или ModelScope и запустили на своей видеокарте.
Какую версию Qwen 3.8 ставить на ноутбук?
Только 27B, и то после квантизации. На мощном ноутбуке она запускается, но генерирует заметно медленнее. Для комфортной работы нужна RTX 4090 или Mac Studio. Max и Omni Flash локально не запустить.
Сколько будет стоить месяц работы на Qwen 3.8 Max?
При 20 агентных задачах в день по 200K входа и 20K вывода выйдет около $310 в месяц без кэша. С кэшированием сумма падает в разы. Та же нагрузка на Fable 5.1 обойдется примерно в $1 800.
Глоссарий
MoE (Mixture of Experts) это архитектура, где модель состоит из множества «экспертов», и на каждый токен включается только часть из них. Так огромная модель работает быстрее.
Омнимодальная модель это нейросеть, которая принимает текст, изображения, аудио и видео в одной архитектуре без промежуточной транскрибации.
Open weights (открытые веса) означает, что файлы модели можно скачать и запустить на своем железе.
SWE-bench Pro это тест на реальных задачах из GitHub-репозиториев, где модель должна исправить баг или добавить фичу.
Terminal-Bench проверяет, как модель работает в командной строке: запускает команды, читает ошибки, исправляет код.
OSWorld оценивает, насколько модель умеет управлять компьютером через интерфейс, как человек с мышкой.
Квантизация это сжатие весов модели с потерей части точности, чтобы она поместилась в память обычной видеокарты.
MCP (Model Context Protocol) это стандарт подключения нейросети к внешним программам, например к Blender или базе данных.
Что делать дальше?
Не выбирайте модель по таблицам. Возьмите одну задачу из своего проекта и прогоните ее через Qwen 3.8 Max и Claude Opus 5, это займет вечер и пару долларов.
Обзоры IDE и агентов, где эти модели подключаются за пару кликов, ищите в каталоге VibeCoderz. Начать проще всего с Claude Code или Cursor.
Если хотите собрать связку моделей под свой продукт и не переплачивать за токены, запишитесь на консультацию к Максиму.
Статья обновлена: октябрь 2026.