Spec-driven development, или SDD, это методология разработки с AI-агентами, где перед кодом пишется спецификация, потом план, потом список задач, и только после этого агент садится за реализацию. Метод решает конкретную проблему вайбкодинга: агент додумывает детали, которые вы не проговорили, и в итоге получает не то, что вы имели в виду. Разберем по шагам, как устроен SDD-процесс, чем отличаются OpenSpec, Spec Kit от GitHub и Taskmaster AI, и как написать первую спецификацию уже сегодня.
SDD-методология останавливает импровизацию агента: спецификация фиксирует что строим, план фиксирует как, задачи разбивают план на проверяемые шаги. GitHub Spec Kit к июлю 2026 собрал больше 123 000 звезд на GitHub, OpenSpec держится на лайтовом варианте того же принципа. В статье: разница подходов, пошаговый фреймворк и промпты для старта.
Что такое spec-driven development простыми словами?
Spec-driven development это разработка, где агент получает не короткий промпт, а формализованный документ: что строим, зачем, какие есть ограничения. Из спецификации агент сам генерирует план и список задач.
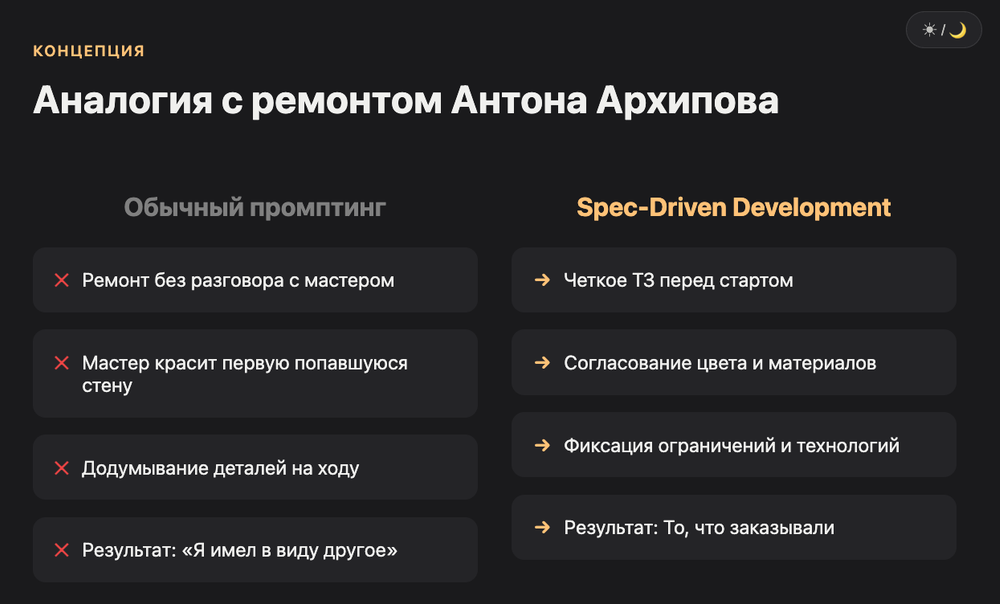
Разработчик JetBrains Антон Архипов на конференции 2026 года сравнил обычный промптинг с ремонтом квартиры без разговора с мастером: приходит человек, красит первую попавшуюся стену, хотя вы имели в виду совсем другую. SDD добавляет этот разговор в процесс. Вы описываете задачу, ограничения и технологии, агент собирает это в спецификацию, вы ее проверяете, и только потом начинается кодинг.
По сути SDD не новая идея. Это перенос практик software engineering, вроде PRD и техдизайна, в контекст работы с LLM. Разница в том, что раньше документ читал человек, а теперь его читает еще и модель, и от четкости формулировок напрямую зависит качество кода.
Почему AI-агент галлюцинирует без спецификации?
Агент без спецификации заполняет пробелы в требованиях своими предположениями, и чем длиннее задача, тем больше таких предположений накапливается. Один и тот же промпт на разных моделях дает планы разной длины и с разными допущениями.
Контекст, а не модель, это самый дефицитный ресурс в работе с агентами. Когда вы просите "сделай батч-джобу для импорта CSV в базу", агент вынужден додумать: есть ли заголовок в файле, что делать с дублями, какой формат даты. Каждое такое додумывание это потенциальная галлюцинация, даже если код при этом компилируется и выглядит рабочим.
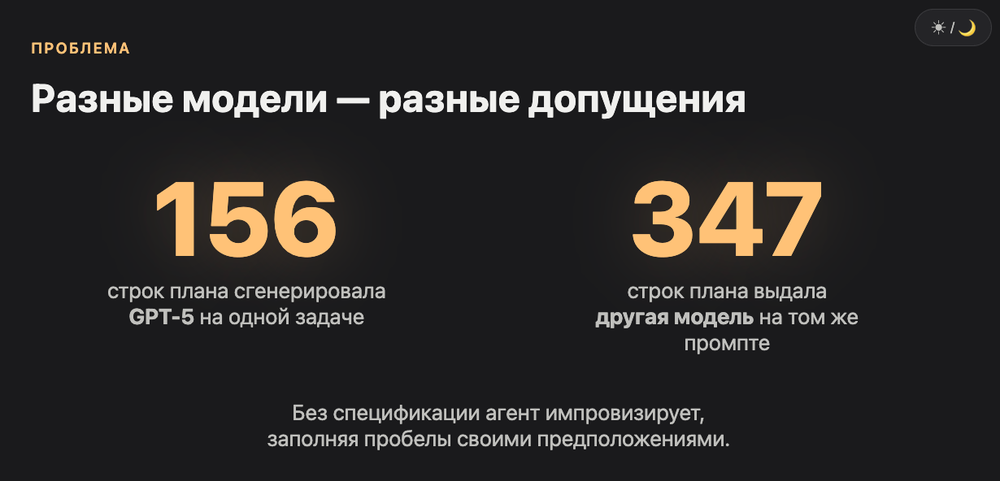
На практике разница между моделями тут заметна сразу. GPT-5 на одной и той же задаче генерирует план на 156 строк, а другая модель на том же промпте выдает план в 347 строк, с другим набором допущений. Ни один из планов не правильный или неправильный сам по себе, просто без явной спецификации агент домысливает по-своему, и результат становится непредсказуемым от запуска к запуску.
Именно поэтому SDD не стоит путать с классическим waterfall. Спецификация здесь не высекается в камне на месяцы вперед. Если она не сработала, вы правите ее и перегенерируете план за минуты, а не пишете техзадание заново через квартал.
Как устроен процесс SDD от спецификации до верификации?
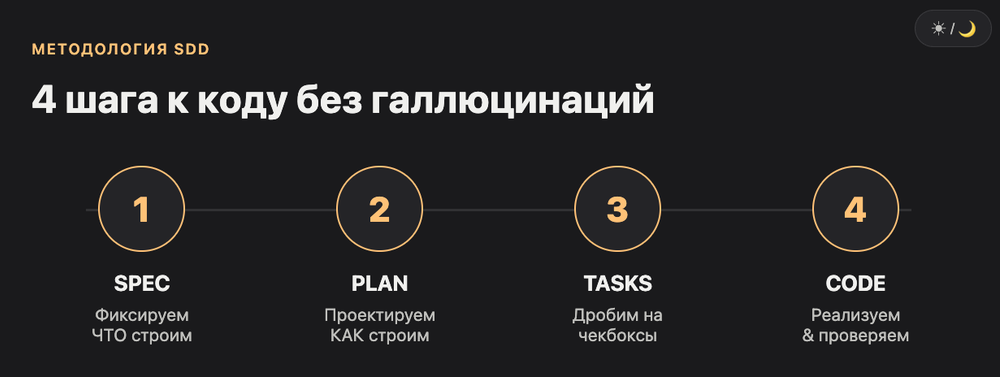
Классический цикл SDD состоит из четырех шагов: спецификация фиксирует требования, план переводит их в архитектурные решения, задачи дробят план на проверяемые единицы, верификация сверяет результат со спецификацией. Каждый шаг живет в отдельном markdown-файле.
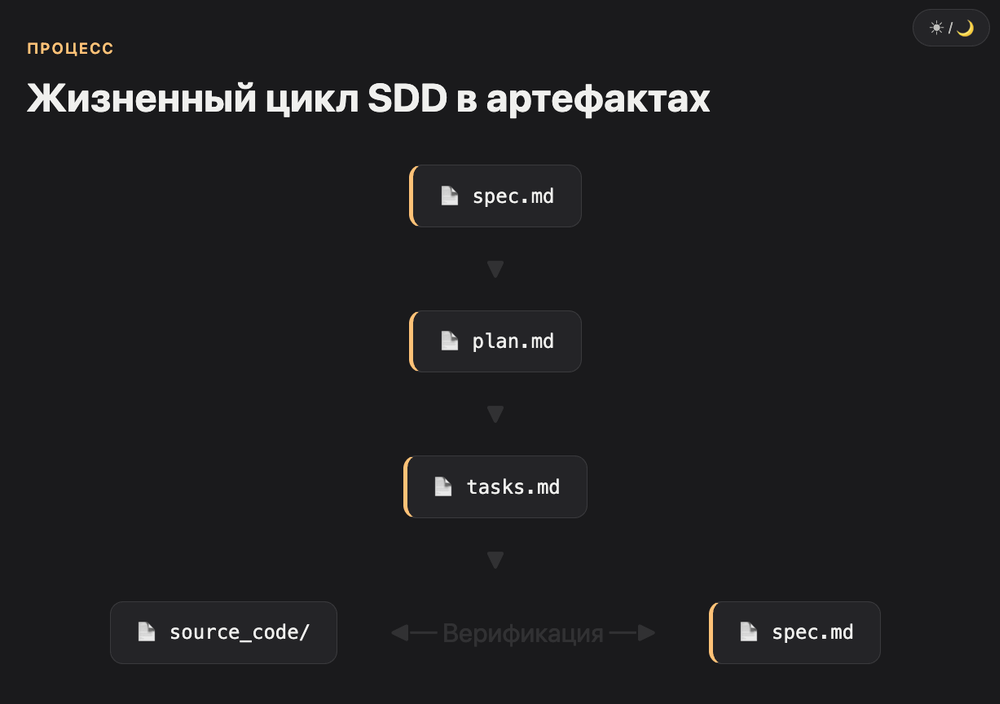
Спецификация что реально нужно построить
Спецификация, или spec, отвечает на вопросы что строим и почему, а не как. Хороший spec включает функциональные требования, явные ограничения ("не используй H2 для тестов, только Testcontainers") и критерии приемки в духе Gherkin: дано, когда, тогда. Чем конкретнее ограничения, тем меньше агенту приходится гадать.
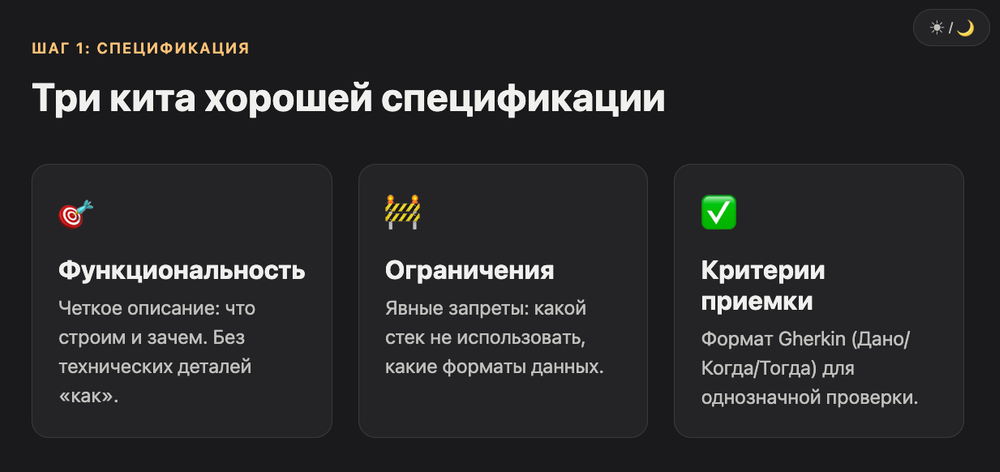
Важно держать spec коротким и читаемым. Заброшенный в контекст документ на тысячу строк markdown агент прочитает, но вы сами перестанете его перечитывать, а без вашего ревью весь смысл дисциплины теряется.
План как агент проектирует решение
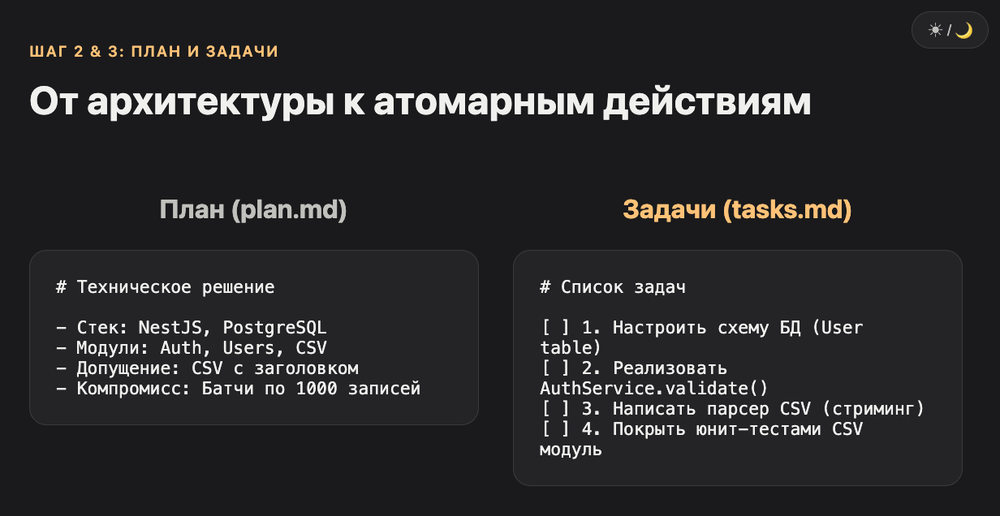
На этом шаге агент превращает спецификацию в техническое решение: какой стек, какие модули, какие компромиссы. Хороший план всегда содержит явные допущения, которые агент сделал сам, например "предполагаю, что в CSV есть заголовок, потому что вы назвали колонки по именам". Эти допущения и есть точки, где чаще всего рождаются галлюцинации, если их не вычитать.
Задачи разбивка на проверяемые шаги
Задачи, task list, это план, разложенный на дискретные пункты с чекбоксами. По сути каждая задача это микропромпт для агента. Слишком мелкая грануляция, вроде "добавь поле name типа string", замедляет работу: агент тратит отдельный запрос на каждую строчку, хотя мог бы обработать связный блок за один заход. Слишком крупная грануляция снова возвращает вас к тем же галлюцинациям, от которых вы уходили.
Верификация как проверить что агент не сочинил
Верификация сверяет реализацию со спецификацией пункт за пунктом, а не просто смотрит "запускается ли код". Открытый вопрос, который пока не решен ни одним инструментом целиком, это обратная трассировка: понять, какие изменения в коде вообще не связаны со спецификацией. Такие изменения либо технический долг, либо неучтенное требование, либо чистая галлюцинация модели, и различить их вручную не всегда просто.
OpenSpec или Spec Kit что выбрать для проекта?
OpenSpec легче и быстрее для итеративной работы над существующим кодом, Spec Kit строже и лучше подходит для новых проектов с нуля. По независимым замерам OpenSpec обходится дешевле по токенам и времени, Spec Kit выигрывает по глубине планирования.
GitHub Spec Kit вышел осенью 2025 года и к июлю 2026 собрал больше 123 000 звезд на GitHub при десятках релизов в месяц. Работает через четырехфазный конвейер: constitution, specify, plan, tasks, implement, где constitution это неизменные правила проекта, которые наследует каждая новая фича. OpenSpec устроен проще: вместо полной документации на фичу вы описываете конкретное изменение, delta, и инструмент трекает только его.
Практическое сравнение на одной и той же задаче показало разницу в цифрах: OpenSpec уложился в 2,5 часа и 30,26 доллара на токенах, Spec Kit на той же задаче потратил 5 часов и 54,83 доллара. При этом Spec Kit сгенерировал больше юнит-тестов, 169 против 96 у OpenSpec, и получил чуть более высокую оценку качества кода.
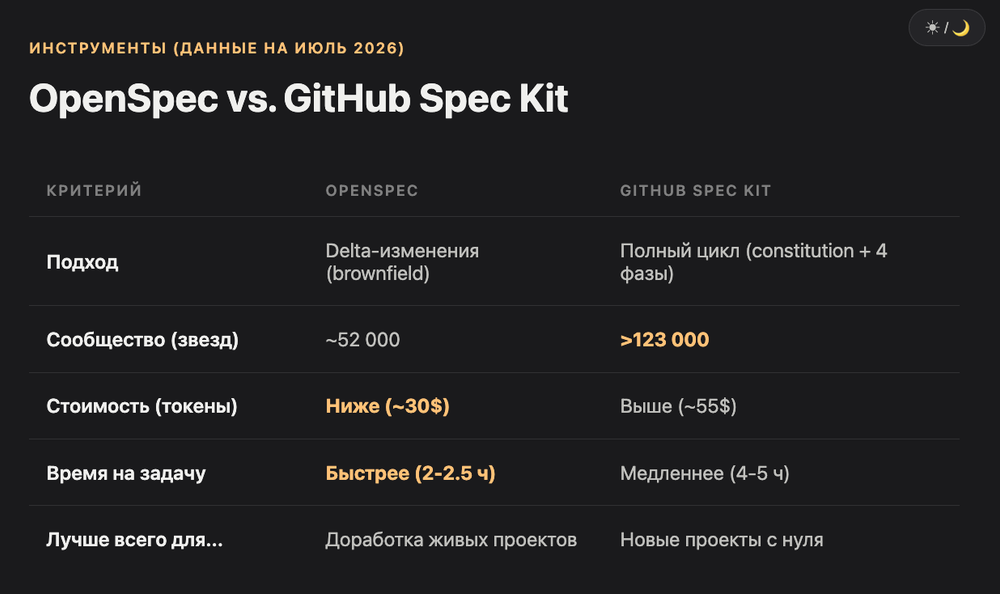
| Критерий | OpenSpec | Spec Kit |
|---|---|---|
| Подход | Delta-изменения, brownfield-first | Полный цикл, constitution + 4 фазы |
| Файлов на фичу | около 4 | 7 и больше |
| Лучше всего для | доработка существующего кода | новые проекты с нуля |
| Стоимость на задачу | ниже (пример: 30 $) | выше (пример: 55 $) |
| Время на задачу | быстрее (2-2,5 часа) | медленнее (4-5 часов) |
| Сообщество к середине 2026 | около 52 000 звезд | больше 123 000 звезд |
Если вы дорабатываете уже живой продукт на VibeCoderz-стеке, вроде Next.js-приложения с Sanity, OpenSpec обычно быстрее заводится и меньше раздувает контекст. Если стартуете новый сервис с нуля и хотите зафиксировать архитектуру сразу, Spec Kit оправдывает лишние часы на планирование. Для агентной работы в связке с Claude Code или Cursor оба инструмента подключаются одинаково просто, через CLI и MCP.
Как Taskmaster AI встраивается в SDD-процесс?
Taskmaster AI это не альтернатива OpenSpec или Spec Kit, а слой управления задачами поверх них. Инструмент парсит PRD, превращает его в дерево задач с зависимостями и оценивает сложность каждой перед стартом.
Taskmaster AI разворачивается как MCP-сервер и подключается к Cursor, Windsurf или Claude Code без смены окружения. Рабочий цикл простой: вы кладете PRD в файл, командой парсите его в задачи, командой analyze complexity смотрите, какие задачи слишком крупные, командой expand дробите их на подзадачи. Дальше один агент выступает "старшим инженером" и генерирует задачи, а второй, подешевле, выполняет их одну за одной.
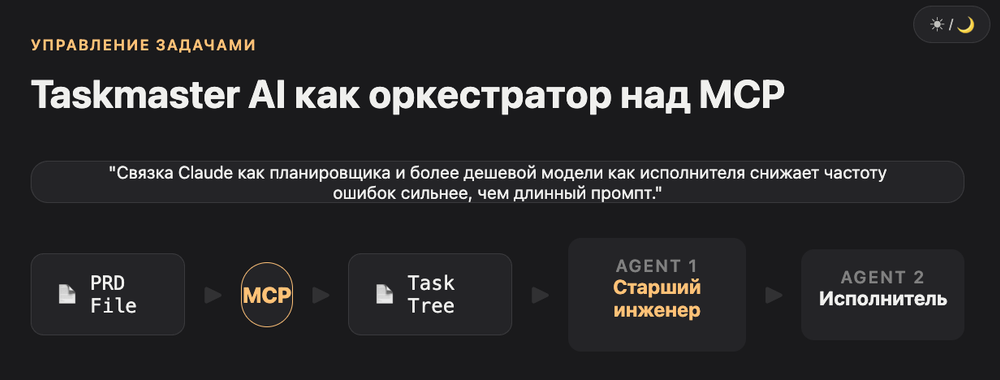
На практике связка Claude как планировщика и более дешевой модели как исполнителя снижает частоту ошибок сильнее, чем просто более длинный промпт. Причина проста: каждая подзадача помещается в контекст целиком, агенту не приходится держать в голове весь проект сразу.
Пошаговый фреймворк SDD с готовыми промптами
Внедрение SDD укладывается в четыре шага и один вечер: написать constitution, сгенерировать спецификацию, разбить на задачи, выполнить с ревью после каждого пункта. Ниже конкретные промпты под каждый шаг.
Шаг 1. Как задать правила проекта?
Начните с короткого файла правил, constitution в терминологии Spec Kit. Если не знаете, что туда писать, поручите это агенту.
Я делаю [тип проекта, например Next.js + Sanity SaaS].
Сформулируй constitution проекта: неизменные принципы архитектуры,
стек, что категорически нельзя делать (например использовать any в TypeScript,
хранить секреты в коде). Дай список из 8-10 пунктов.
Шаг 2. Как написать спецификацию фичи?
Опишите фичу простым языком, а не техническим заданием. Агент сам переведет ее в структуру.
Хочу добавить [фича, например JWT-аутентификацию с refresh-токенами].
Составь спецификацию: цель, что входит в задачу, что явно не входит,
ограничения по безопасности и производительности, критерии приемки
в формате дано/когда/тогда. Не пиши код, только спецификацию.
Шаг 3. Как получить план и список задач?
На основе спецификации выше составь технический план: стек, модули,
компромиссы, явные допущения, которые ты делаешь о проекте.
Затем разбей план на список задач с чекбоксами, каждая задача
должна быть выполнима за один запрос и содержать критерий готовности.
Шаг 4. Как выполнить задачи без потери контроля?
Не бросайте весь список одним промптом, особенно если в проекте уже тысячи файлов. Запускайте implement в новой сессии на конкретную задачу.
Реализуй только задачу #3 из tasks.md. После реализации отметь чекбокс,
покажи unified diff, и укажи, отличается ли итоговый код от того,
что описано в спецификации, и если да, то чем именно.
После каждого шага сверяйте вывод с исходной спецификацией. Это и есть верификация, и пропускать ее нельзя даже при полном доверии к модели.
Какую модель выбрать для спецификации, а какую для кода?
Для генерации спецификации и плана выгоднее брать топовую reasoning-модель, она находит больше неочевидных требований. Для рутинного выполнения задач по готовому плану подойдет модель дешевле, разница в качестве на этом этапе минимальна.
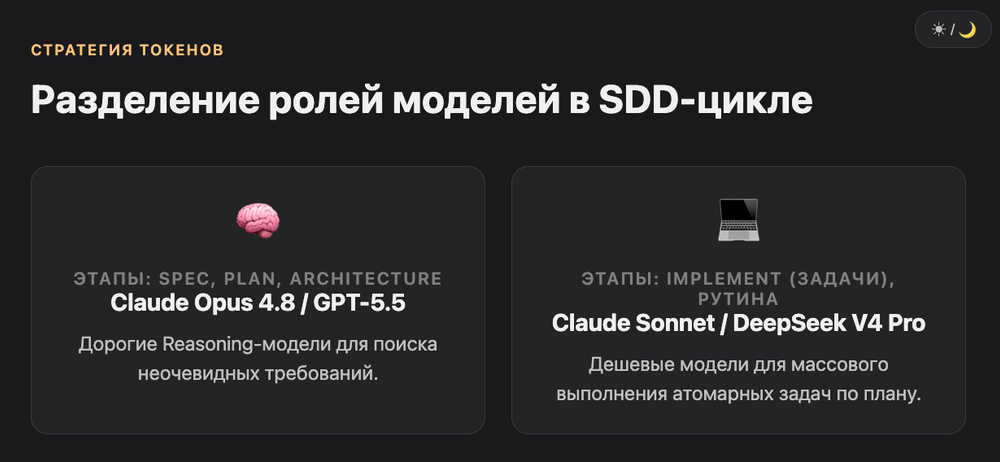
По данным OpenRouter на июнь 2026 года разрыв между топовыми моделями и моделями среднего тира по SWE-bench Verified составляет буквально доли процента, зато разница в цене кратная.
| Модель | Цена (input/output за 1M токенов) | SWE-bench Verified | Роль в SDD-цикле |
|---|---|---|---|
| Claude Opus 4.8 | $5 / $25 | 88,6% | Спецификация и план, сложная архитектура |
| Claude Sonnet 4.6 | $3 / $15 | 79,6% | Универсальный баланс, implement-фаза |
| Gemini 3.1 Pro | $2 / $12 | 80,6% | Большие кодовые базы, длинный контекст |
| DeepSeek V4 Pro Max | $0,435 / $0,87 | 80,6% | Массовое выполнение задач по готовому плану |
| Claude Haiku 4.5 | $1 / $5 | лидер по цене за очко | Мелкие рутинные подзадачи, быстрый implement |
Практический паттерн: спецификацию и план генерирует дорогая модель вроде Opus 4.8, потому что именно на этом шаге цена ошибки в допущениях самая высокая. Реализацию по готовому чекнутому плану можно смело отдавать модели уровня Sonnet или даже DeepSeek, экономия на токенах ощутима на проектах с десятками задач.
Какие у SDD сильные и слабые стороны?
SDD честно решает проблему потерянного контекста между сессиями. Задачи и спецификация лежат в файлах, а не в чате, поэтому переживают падение агента, обрыв связи или просто перезапуск сессии на следующий день. Ревьюер видит не тысячи строк непонятно откуда взявшегося кода, а трассируемый путь от требования до реализации.
Слабые стороны тоже стоит проговорить честно. SDD добавляет 20-40% токенов на фичу по сравнению с прямым промптингом, и это ощутимо на больших проектах. Дисциплину нельзя автоматизировать полностью: если вы перестанете вычитывать спецификации и планы, инструмент выродится в генератор красивых markdown-файлов без связи с реальным кодом. На маленьких задачах, вроде правки одной функции, полный цикл constitution-specify-plan-tasks выглядит избыточно, тут вайбкодинг без спецификации быстрее.
Максим: «VibeCoderz мы собрали за неделю тремя скриптами, начитанными голосом прямо в Claude Code. 6 200 материалов в каталоге. Без четкого плана в голове перед стартом это растянулось бы на месяцы, а тут просто знал, что и в каком порядке агент должен сделать.»
Кому реально подходит spec-driven development?
SDD оправдан там, где цена ошибки высокая: продакшн-код, командная работа, легаси-проекты. Для одноразовых скриптов и быстрых прототипов методология скорее замедлит, чем поможет.
| Сценарий | Нужен ли SDD | Что использовать |
|---|---|---|
| Быстрый прототип, POC | Нет | Прямой промптинг, вайбкодинг |
| Новый продакшн-проект с нуля | Да | Spec Kit |
| Доработка живого проекта | Да | OpenSpec |
| Команда из нескольких разработчиков | Да | Spec Kit + Taskmaster AI |
| Легаси-код без документации | Осторожно | OpenSpec, начать со спецификации существующих модулей |
| Соло-разработчик, пет-проект | По желанию | OpenSpec или свой minimal workflow |
Новичкам, которые еще не писали код руками, стоит начать не с инструмента, а с ручного упражнения: опишите фичу спецификацией в обычном markdown-файле, без Spec Kit и OpenSpec, и попросите агента реализовать строго по ней. Так вы почувствуете разницу до того, как разбираться с CLI и конфигами.
Если задача связана с автоматизацией процессов, а не только с кодом, посмотрите каталог AI-агентов VibeCoderz, там подобраны решения под конкретные профессии и задачи, включая агентов для разработчиков.
Частые вопросы про Spec-Driven Development
Чем SDD отличается от обычного вайбкодинга? Вайбкодинг это диалог с агентом без промежуточных документов: написали промпт, получили код, поправили промптом же. SDD добавляет письменную спецификацию и план между идеей и кодом, поэтому результат легче повторить и проверить.
Нужен ли SDD для маленьких задач? Нет. Для правки одной функции или скрипта на час полный цикл constitution-specify-plan-tasks избыточен. SDD окупается на задачах, где цена ошибки или забытого требования высокая.
Можно ли использовать OpenSpec и Spec Kit вместе? Технически да, но обычно команды выбирают один инструмент под этап проекта: Spec Kit на старте, когда важна строгая архитектура, OpenSpec позже, когда проект живой и меняется небольшими итерациями.
SDD это то же самое, что TDD? Нет, но идейно близко. TDD фиксирует ожидаемое поведение через тесты до кода, SDD фиксирует требования через спецификацию до кода. Некоторые считают SDD естественным развитием TDD для эпохи агентов.
Какая модель лучше всего пишет спецификации? На середину 2026 года для спецификаций и планов чаще выбирают Claude Opus 4.8 или GPT-5.5 из-за более сильного reasoning на длинных цепочках рассуждений. Для выполнения готовых задач разница между моделями по качеству куда меньше, чем по цене.
Работает ли SDD в легаси-проекте без документации? Работает, но тяжелее. Сначала придется восстановить спецификации для уже существующих модулей, а это ручная и не быстрая работа. OpenSpec для такого сценария подходит лучше, чем Spec Kit.
Сколько времени уходит на внедрение SDD в проект? Первую спецификацию и план реально написать за вечер. Полноценный workflow с constitution и task list на команду обычно занимает от нескольких дней до недели на настройку и обкатку.
Хотите внедрить spec-driven development в свой проект, но не знаете, с чего начать в вашем стеке? Посмотрите обзоры инструментов в каталоге VibeCoderz или запишитесь на консультацию к Максиму, разберем вашу задачу и подберем связку инструментов под нее.
Обновлено: октябрь 2026.