Обновлено: октябрь 2026
Облачный парсер сайтов снимает с вас головную боль с прокси, CAPTCHA и блокировками. Вместо того чтобы тратить недели на настройку инфраструктуры, вы делаете один API-запрос — сервис разбирается со всем остальным и возвращает чистые данные. В этой статье разобрали шесть лучших сервисов: бесплатные тарифы, реальные цены, SDK на Python/Node.js и честные минусы каждого.
ScraperAPI, Apify, Firecrawl, ScrapingBee, Bright Data и Zyte — шесть сервисов с разными сильными сторонами. ScraperAPI удобен для старта (1000 бесплатных кредитов, один API-запрос). Apify дает маркетплейс из 25 000+ готовых скрейперов. Firecrawl возвращает Markdown вместо HTML — идеально для AI-агентов. ScrapingBee подходит для JavaScript-сайтов. Bright Data и Zyte — выбор для enterprise и сложных антибот-защит. Цены и лимиты актуальны на июнь 2026.
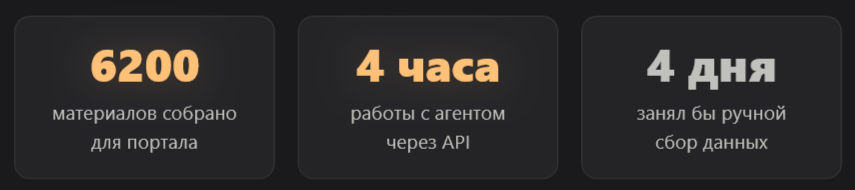
Почему стоит выбрать облачный парсер, а не поднимать свой?
Поднять собственный парсинг-сервер реально, но дорого по времени. Облачный парсер с API решает три проблемы сразу: ротация прокси, обход CAPTCHA и JavaScript-рендеринг — всё без вашего участия.
Вот честный расчет. Средний разработчик тратит 2–4 недели только на то, чтобы поднять надежный стек с headless-браузером, прокси-ротацией и антибот-обходом. Облачный сервис дает всё это за один API-вызов от $49 в месяц.
Другая история — Firecrawl, который один из наших авторов подключил к Claude Code за один вечер. Результат: AI-агент получает чистый Markdown вместо грязного HTML и сжигает в разы меньше токенов на обработку страниц Авито и маркетплейсов.
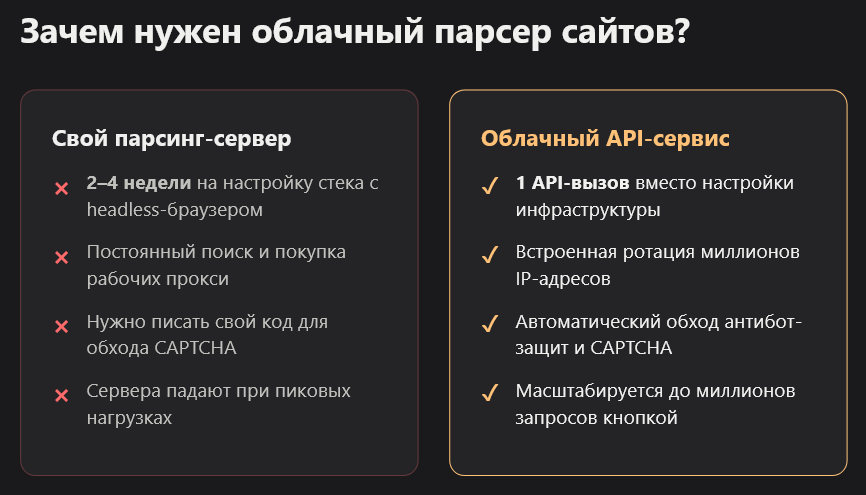
Максим: «Мы в VibeCoderz собрали весь портал — 6200 материалов — за неделю тремя скриптами голосом в Claude Code. Firecrawl был частью этой связки. Один API-ключ, и агент видит сайт как чистый текст, а не как кашу из HTML-тегов. 4 часа работы против 4 дней ручного сбора данных — вот такие пироги.»
Если вы строите AI-пайплайны, автоматизацию или просто не хотите держать сервер — читайте дальше.
Как мы выбирали и что проверяли?
Для обзора взяли шесть самых упоминаемых сервисов среди разработчиков в 2026 году. Каждый проверяли по пяти критериям: бесплатный тариф, SDK, обход Cloudflare, прозрачность цен и порог входа.
Ни один из сервисов не платил нам за упоминание. Критерии отбора:
- наличие REST API и официального SDK для Python или Node.js
- бесплатный тариф или триал без карты
- актуальные данные о ценах (июнь 2026)
- реальные бенчмарки по success rate
Данные о бенчмарках частично взяты из независимого исследования Proxyway 2025.
ScraperAPI — лучший старт для большинства задач
ScraperAPI берет на себя ротацию прокси, CAPTCHA и JavaScript-рендеринг за один API-вызов. Бесплатный тариф: 1000 кредитов в месяц + 7-дневный триал на 5000 запросов без карты.
ScraperAPI — это один HTTP-запрос вместо настройки целого стека. Вы отправляете URL, сервис возвращает HTML. Прокси, заголовки, CAPTCHA — всё скрыто за одним endpoint.
Что умеет:
- пул из 40+ млн IP по всему миру
- JS-рендеринг через Chromium
- структурированный вывод JSON/CSV для Amazon, Google и популярных сайтов
- async-режим для пакетных задач
- интеграция с LangChain для AI-агентов
- DataPipeline (no-code вариант для тех, кто не хочет писать код)
Цены на июнь 2026:
| Тариф | Цена | Кредиты | Потоки |
|---|---|---|---|
| Free | $0 | 1 000/мес | 5 |
| Hobby | $49/мес | 100 000 | 20 |
| Startup | $149/мес | 1 000 000 | 50 |
| Business | $299/мес | 3 000 000 | 100 |
| Enterprise | Custom | Custom | Custom |
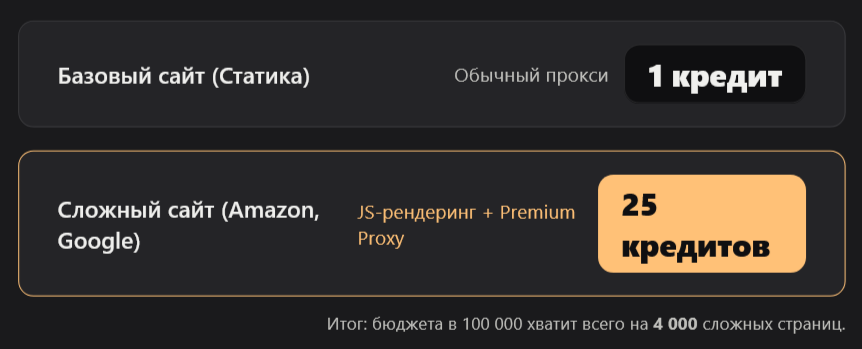
Одна деталь, которую легко пропустить: кредиты множатся при сложных запросах. Базовый сайт = 1 кредит. Amazon с JS-рендерингом = 5 кредитов. Премиальные прокси + рендеринг = 25 кредитов. То есть на Hobby-плане за $49 вы можете получить всего 4000 сложных запросов вместо заявленных 100 000. Считайте реальную стоимость через cost estimation endpoint до запуска больших задач.
Честный минус: Hobby и Startup планы ограничены регионами US и EU. Для других регионов нужен Business или Enterprise.
Для AI-агентов, которым нужен реальный веб-контент в реальном времени, ScraperAPI поддерживает LangChain-интеграцию — это заметно упрощает сборку пайплайнов.
SDK есть для Python, Node.js, PHP, Ruby.
Apify — маркетплейс из 25 000+ готовых скрейперов
Apify — облачная платформа с маркетплейсом акторов (готовых скрейперов). Бесплатный тариф: $5 кредитов в месяц, ~5000 простых страниц без карты.
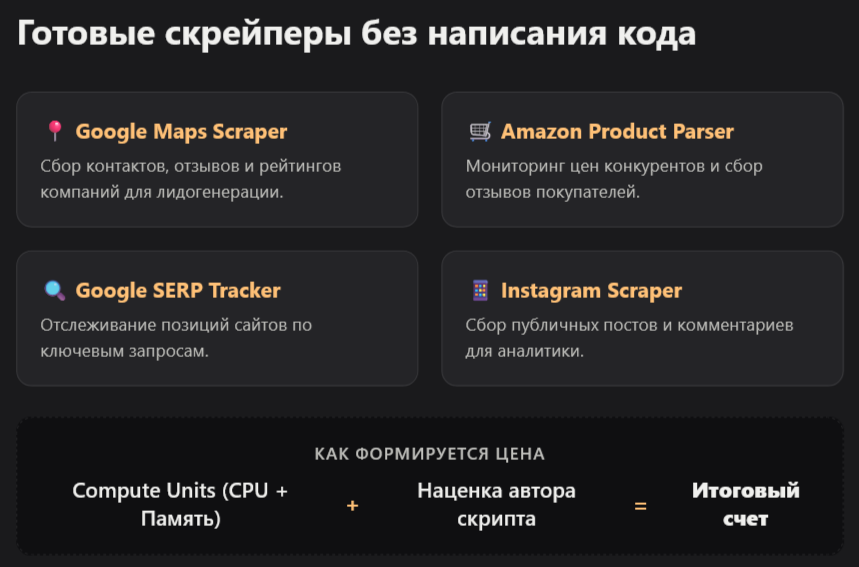
Apify работает не так, как обычный парсер. Вместо того чтобы вы писали скрейпер с нуля, вы берете готовый «актор» из маркетплейса — их там 25 000+. Нужны данные из Google Maps, LinkedIn, Amazon, TikTok или Instagram — скорее всего, актор уже есть. Запускаете, настраиваете параметры в UI, получаете данные в JSON или CSV.
Популярные сценарии:
- мониторинг конкурентов
- лидогенерация из Google Maps и каталогов
- отслеживание цен на Amazon и Shopify
- SERP-мониторинг по ключевым словам
- извлечение контента для обучения AI-моделей
Цены на июнь 2026:
| Тариф | Цена | Credits | Потоки |
|---|---|---|---|
| Free | $0 | $5 кредитов/мес | 25 |
| Starter | $29/мес | $29 credits | 32 |
| Scale | $199/мес | $199 credits | 100+ |
| Business | $999/мес | $999 credits | 256 |
Apify считает не запросы, а compute units — CPU + память за время выполнения. Простой легкий актор (Google Search) обходится примерно в $0.001–0.002 за страницу. Headless Chrome с рендерингом — в 5–10 раз дороже.
Есть еще один момент: многие акторы в Store имеют собственный прайс поверх compute units. Актор, который стоит $4 за 1000 результатов, способен сжечь весь $29-бюджет незаметно — usage chart при этом будет выглядеть нормально. Смотрите вкладку Pricing у конкретного актора до масштабирования.
Разработчики могут публиковать свои акторы на маркетплейсе и получать деньги за использование. Это реальная монетизация: данные Apify показывают, что популярные акторы приносят авторам стабильный доход.
Студентам — 50% скидки на платные планы с .edu-почтой.
Firecrawl — выбор для AI-агентов и LLM-пайплайнов
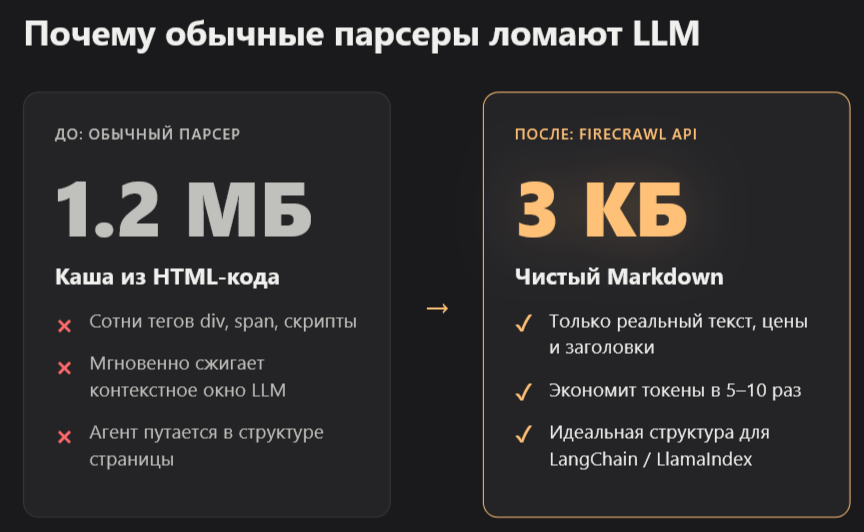
Firecrawl конвертирует любую страницу в чистый Markdown. Это критично для AI-агентов: вместо грязного HTML модель получает структурированный текст и тратит в разы меньше токенов. Бесплатно: 1000 кредитов/мес без карты.
Обычный парсер отдает HTML — и вашему AI-агенту приходится разбирать гору тегов, скриптов и атрибутов. Firecrawl делает иначе: возвращает чистый Markdown с реальным содержимым страницы.
На практике это выглядит так. Страница товара на Wildberries весит 1.2 МБ HTML. После Firecrawl это 3 КБ Markdown с названием, ценой, описанием и отзывами. Токены тратятся на данные, а не на HTML-мусор.
Что умеет:
- конвертация в Markdown или структурированный JSON
- обход блокировок (в том числе Авито)
- интеграции с LangChain, LlamaIndex, n8n, Lovable, Zapier
- поиск по интернету с полным содержимым страниц за один вызов
Цены на июнь 2026:
| Тариф | Цена | Кредиты | Потоки |
|---|---|---|---|
| Free | $0 | 1 000/мес | 2 |
| Hobby | $16/мес | 5 000 | — |
| Standard | $83/мес | 100 000 | 50 |
| Growth | $333/мес | 500 000 | 100 |
| Scale | $599/мес | 1 000 000 | 150 |
Нюанс с кредитами: 1 простой скрейп = 1 кредит. Если нужна AI-экстракция (структурированные данные из произвольного сайта) — это уже 5 кредитов за запрос. При смешанной нагрузке 60/40 (базовые и AI-запросы) реальная стоимость примерно 2.6 кредита на страницу.
Еще одно: AI Extract — это отдельная подписка от $89/мес поверх кредитного плана. Если бюджетируете под полный функционал, учитывайте обе строки.
При регистрации дают 500 бесплатных кредитов — достаточно, чтобы полноценно протестировать перед решением о подписке.
Для вайбкодеров, которые строят агентов с Claude Code или Cursor: Firecrawl подключается за 10 минут через API-ключ, дальше агент видит любой сайт как чистый текст.
ScrapingBee — простой API для JavaScript-сайтов
ScrapingBee специализируется на динамических сайтах с JavaScript-рендерингом. Бесплатно: 1000 API-вызовов без карты. Платные планы от $49/мес.
ScrapingBee был приобретен Oxylabs в июне 2025 года, но работает как отдельный продукт. Его выбирают, когда нужен чистый REST API без лишних сложностей.
Что умеет:
- рендеринг JavaScript-сайтов (React, Vue, Angular)
- встроенный Google SERP API (отдельная фича, полезна для SEO-мониторинга)
- ротация прокси без настройки
- скриншоты страниц
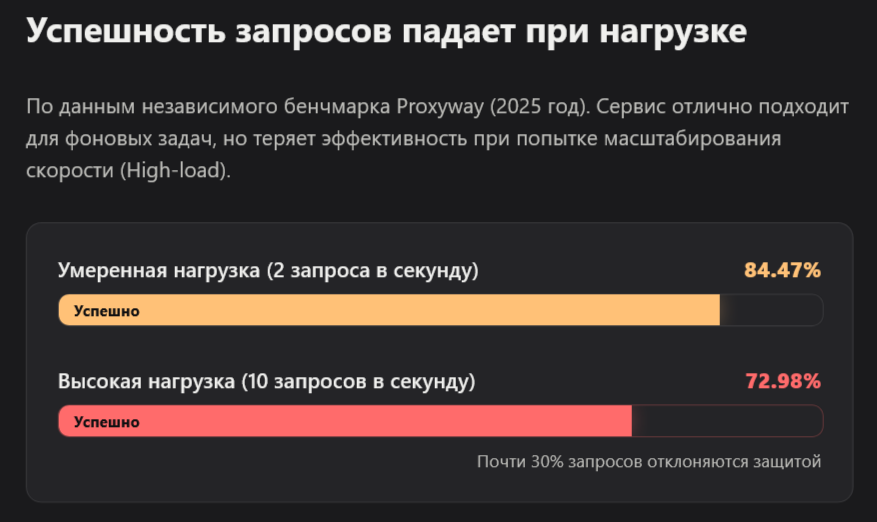
По бенчмарку Proxyway 2025, ScrapingBee показал 84.47% успешных запросов при 2 req/sec, но при 10 req/sec этот показатель падал до 72.98%. Для умеренных нагрузок — нормально, для высоких — смотрите на Zyte или Bright Data.
Цены: Free (1000 вызовов), от $49/мес за 100K кредитов. Система с мультипликаторами, как у ScraperAPI.
Хороший вариант для команд, которым нужна конкретная задача: парсинг Google-результатов, мониторинг конкурентов, проверка мета-тегов.
Bright Data — enterprise-инфраструктура с 400+ млн IP
Bright Data — крупнейшая прокси-сеть в мире: 400+ млн IP в 195 странах. Бесплатного тарифа нет, но есть трехдневный триал. Подходит для enterprise и задач, где важна максимальная надежность.
Если предыдущие сервисы — это инструменты для разработчиков, то Bright Data — это уже инфраструктура. Компания держит 400+ млн резидентских IP, соответствует GDPR, CCPA, ISO 27001 и SOC 2. Для команд в финансах, здравоохранении или других регулируемых отраслях это важно.
Что входит в продукт:
- резидентские, датацентровые и мобильные прокси
- Web Scraper API с 120+ готовыми датасетами
- Browser API для сложных JS-сценариев
- готовые датасеты по нишам (e-commerce, SERP, финансы)
Цены: резидентские прокси — от $8/ГБ pay-as-you-go. Активная промокод-акция RESIGB50 дает 50% скидки на первые 3 месяца, эффективная цена — $4/ГБ. Web Scraper API — от $499/мес для SERP.
Bright Data дороже конкурентов по любому сегменту. Оправдано, если ваши цели защищены серьезным антиботом или если нужны SLA-гарантии для production-пайплайна.
Zyte — лучший success rate на защищенных сайтах
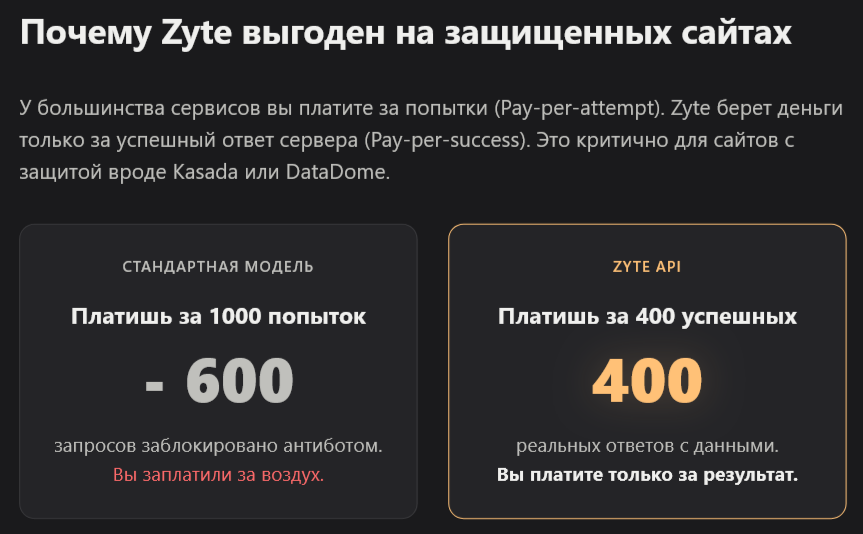
Zyte (бывший Scrapinghub) показывает лучшие результаты на сайтах с Kasada и DataDome по независимым бенчмаркам. Цена: от $0.13 за 1000 простых запросов pay-as-you-go, без обязательной месячной платы.
Zyte — это не один инструмент, а платформа из трех продуктов с отдельным биллингом: Zyte API (основной endpoint), Smart Proxy Manager и Zyte Data (готовые датасеты). Нюанс: если вам нужны все три — счет будет от трех разных строк.
Сильная сторона: Zyte берет деньги только за успешные ответы, не за попытки. При сложных целях с высоким процентом блокировок это реально выгоднее, чем pay-per-attempt у других.
Цены: pay-as-you-go от $0.13 за 1000 HTTP-запросов. Без минимальной месячной суммы на базовом уровне. При коммите $500/мес цена падает до $0.06 за 1000.
Честный минус Zyte: при масштабировании стоимость становится непредсказуемой. На easy-целях они дешевые. На protected-сайтах с Advanced anti-bot стоимость растет быстро. Бюджетируйте с запасом.
Для команд, которые уже используют Scrapy, Zyte — почти очевидный выбор: там есть Scrapy Cloud, managed-хостинг для Python-пайплайнов.
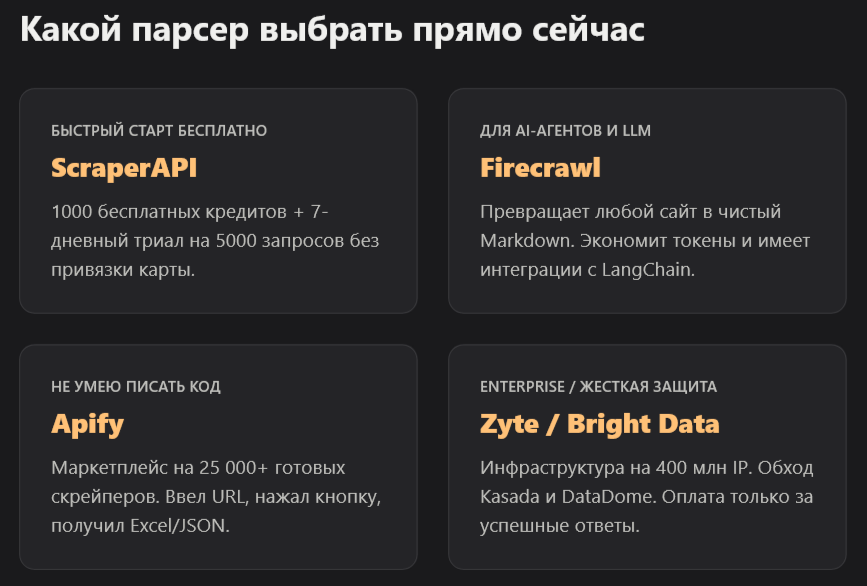
Сравнительная таблица: какой парсер выбрать?
Используйте таблицу как отправную точку — финальный выбор зависит от конкретной задачи и объема.
| Сервис | Бесплатно | Старт платного | Для AI-пайплайнов | Сложные сайты | SDK |
|---|---|---|---|---|---|
| ScraperAPI | 1000 кредитов + 5000 триал | $49/мес | LangChain | Средне | Python, Node, PHP |
| Apify | $5 credits | $29/мес | Акторы для LLM | Средне | Python, JS |
| Firecrawl | 1000 кредитов | $16/мес | ★★★ Markdown output | Хорошо | Python, Node, Go |
| ScrapingBee | 1000 вызовов | $49/мес | Базово | Средне | Python, Node |
| Bright Data | Нет | ~$8/ГБ | Датасеты | ★★★ | Python, Node, Java, C# |
| Zyte | Нет (PAYG от $0) | $0.13/1000 req | Scrapy Cloud | ★★★ | Python, Node |
Быстрый выбор по задаче:
- Тест без карты → ScraperAPI (7-дневный триал на 5000 кредитов)
- Готовые скрейперы без кода → Apify Actor Marketplace
- AI-агент или LLM-пайплайн → Firecrawl (Markdown output)
- Мониторинг Google SERP → ScrapingBee (встроенный Google API)
- Enterprise и соответствие требованиям compliance → Bright Data
- Защищенные сайты с Kasada/DataDome → Zyte
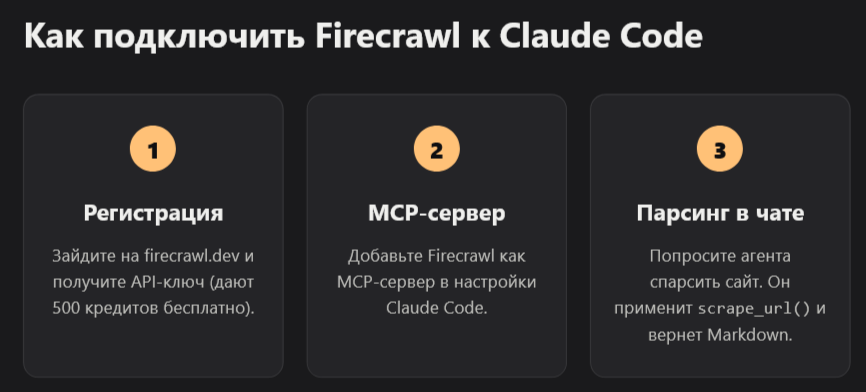
Как подключить Firecrawl к Claude Code за 10 минут
Если вы вайбкодер и хотите дать AI-агенту доступ к веб-контенту — Firecrawl + Claude Code это самая короткая дорога. Вот базовая инструкция.
Шаг 1. Зарегистрируйтесь на firecrawl.dev и получите API-ключ. При регистрации — 500 бесплатных кредитов.
Шаг 2. В Claude Code добавьте Firecrawl как MCP-сервер. Инструкция доступна в официальной документации Firecrawl в разделе MCP.
Шаг 3. Теперь агент умеет парсить любой URL через команду. Пример в Python:
from firecrawl import FirecrawlApp

app = FirecrawlApp(api_key="fc-ваш-ключ")
result = app.scrape_url("https://example.com", params={"formats": ["markdown"]})
print(result["markdown"])
Агент получает чистый Markdown — никакого HTML-мусора. Токены тратятся на реальный контент.
Подробный кейс: как Firecrawl подключили к Claude Code для парсинга Авито и маркетплейсов.
Частые вопросы об облачных парсерах
Какой облачный парсер лучше для новичка?
ScraperAPI — 1000 бесплатных кредитов в месяц, один API-запрос вместо сложной настройки прокси. Apify подойдет тем, кто хочет использовать готовые скрейперы без написания кода.
Какой парсер умеет обходить Cloudflare?
Zyte показывает лучшие результаты по Kasada и DataDome по независимым бенчмаркам 2025 года. Bright Data и Oxylabs тоже справляются с защищенными сайтами, но стоят дороже.
Есть ли бесплатный облачный парсер с API?
Да. ScraperAPI дает 1000 кредитов + 7-дневный триал на 5000 запросов без карты. Apify — $5 в месяц на compute credits. Firecrawl — 1000 кредитов. ScrapingBee — 1000 бесплатных вызовов.
Что такое кредит и как считать расходы?
Кредит — единица запроса. Один HTTP-запрос к статичному сайту = 1 кредит. JS-рендеринг или премиальные прокси дают умножитель 5–25x. Считайте реальную стоимость через cost estimation endpoint до запуска.
Можно ли парсить Авито или ВКонтакте?
Технически да. Firecrawl с Claude Code используется для парсинга Авито. Но каждая платформа имеет свои ToS — нарушение может привести к бану. Для таких задач выбирайте сервисы с ротацией резидентских прокси.
SDK на Python и Node.js есть у всех?
У ScraperAPI, Apify, Firecrawl и Zyte есть SDK для Python и JavaScript. Bright Data дополнительно поддерживает Java, C#, Ruby. ScrapingBee работает через REST API.
Что выбрать для AI-агентов?
Firecrawl — оптимальный выбор: возвращает чистый Markdown вместо HTML, сокращает расход токенов в разы. Есть нативные интеграции с LangChain и LlamaIndex.
Итог: какой облачный парсер выбрать прямо сейчас?
Нет универсального ответа — только правильный выбор под задачу.
Если вы начинаете и хотите потестировать без карты — берите ScraperAPI (7-дневный триал на 5000 кредитов) или Firecrawl (1000 кредитов навсегда). Обе регистрации занимают две минуты.
Если строите AI-агента — Firecrawl. Markdown-вывод режет расход токенов в 5–10 раз по сравнению с сырым HTML.
Если нужны готовые скрейперы без кода — Apify Actor Marketplace, там уже есть практически всё.
Если работаете с защищенными целями на enterprise-уровне — смотрите Zyte или Bright Data.
Все упомянутые инструменты — в каталоге VibeCoderz. Там же найдете обзоры Claude Code, Cursor и других IDE для вайбкодинга.
Если хотите разобраться, как встроить парсинг в AI-агента под вашу конкретную задачу — запишитесь на консультацию к Максиму.
Обновлено: октябрь 2026. Цены актуальны на дату публикации — перед покупкой проверяйте на официальном сайте сервиса, тарифы меняются.